编译器设计阅读笔记 —— (一)编译概论
本系列文章主要是我在学习编译器设计(第二版)时的读书笔记。笔记内容可能未能详尽概括原著精髓,强烈建议有兴趣的读者结合原书一同阅读,以构建更完整的知识体系。
此外,由于本人初次深入学习该领域,学识所限,笔记中难免存在理解偏差或疏漏谬误之处。恳请各位读者不吝赐教,多多批评指正。
编译器简介
编译器的核心功能是将源程序映射到目标程序,而解释器则是将程序映射到其执行结果。以常见的脚本语言为例,Python 和 Perl 主要是通过解释器执行。
Java 则是一个混合了编译和解释的典型例子:Java 程序首先被编译器转换为字节码;然后,这些字节码在 JVM(Java 虚拟机)中被解释执行;同时,对于频繁被调用的“热点”字节码,JIT(即时编译器)会将其进一步编译为目标机器的机器码,以提高执行效率。
编译器的基本原则
编译器在工作时必须遵循两个基本原则:
保持语义:编译器必须保证其生成的程序与被编译的源程序在语义上是完全等价的。
改进程序:编译器必须以某种可觉察的方式改进输入程序,例如提高其运行速度或减少资源占用。
编译器结构
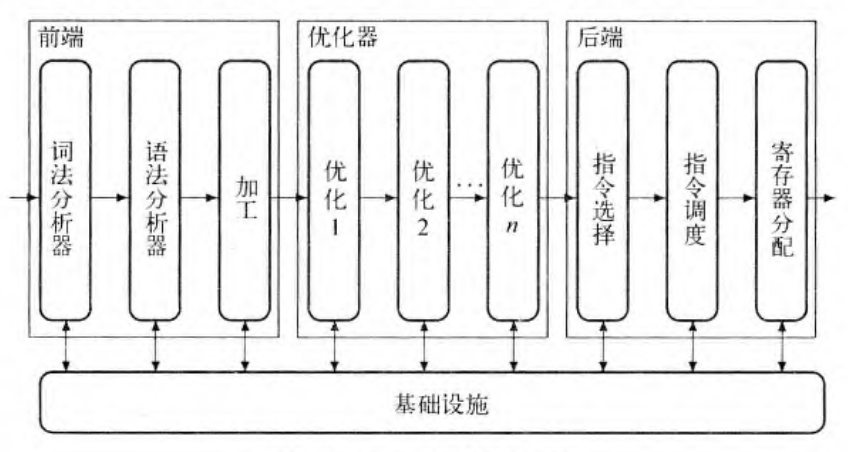
在单个编译器中,需要执行两种性质截然不同的任务:一是理解并分析源程序,二是将理解分析的结果映射到目标机。据此,编译器被划分为前端 (Frontend) 和后端 (Backend)。
前端和后端之间通过中间表示 (Intermediate Representation, IR) 来解耦。前端负责生成 IR,并将其传递给后端。这个 IR 必须包含代码所有的语义信息以及前端的分析结果。这种解耦形成了一种“契约”:后端可以假定它收到的 IR 不包含任何语义或语法错误,因为这些问题必须由前端负责处理。
由于 IR 的引入,我们还可以在前端和后端之间插入一个优化器 (Optimizer)。优化器负责实现从 IR 到 IR 的转换,目的是改进 IR 的质量。从这个定义上看,优化器本身也是一种编译器。
因此,一个典型编译器的结构由前端、优化器和后端组成,它们在传递 IR 的基础上共享一套基础设施。
转换概述
前端
前端的主要职责是检查语法并生成中间表示。 检查语法的过程通常包含:
词法分析器(通常为 1-Pass):将程序由字符串转换为“单词”流 (Token)。
语法分析器(通常为 1-Pass):判断输入的单词流是否是源语言的一个合法的“句子”。这个过程通常会构建一个树形结构,即抽象语法树 (Abstract Syntax Tree, AST)。
类型检查(通常为 1-Pass):检查程序中的类型是否一致。
完成上述检查后,前端会生成 IR。
优化器
优化器的工作流可以概括为两个核心步骤:分析 (Analysis) 和转换 (Transformation)。它首先对 IR 进行分析,然后基于分析结果对 IR 进行等价的转换。
后端
后端负责将 IR 转换为目标机器代码,这个过程包含几个关键步骤:
指令选择:将 IR 重写为目标机支持的原生操作。
寄存器分配:在 IR 中,我们假设寄存器有无限多个;在寄存器分配阶段,必须决定哪些值能实际驻留在目标机器有限的物理寄存器中。
指令调度:通过对代码进行重排,以便在目标机器的性能约束下取得最佳性能。
在代码生成过程中,各组件之间存在复杂的交互与制约。例如,指令调度倾向于将 load 指令远离依赖其结果的指令(以便利用流水线),但这反过来会让寄存器被占用的时间更长,给寄存器分配带来压力。此外,如果寄存器分配将两个本无依赖的指令所需的值映射到了同一个物理寄存器,就会在它们之间建立“伪依赖”关系,这又会限制指令调度的效果。虽然重命名可以消除这种伪依赖,但代价是需要使用更多的寄存器。
编译器构建是一种工程行为,因此必须关注编译时成本,这包括算法的渐进复杂度、实际运行时间以及数据结构占用的空间。
词法分析和语法分析已有大量高效算法,其复杂度通常为 O(n),因此这些任务只应占用很小一部分编译时间。
相比之下,优化和代码生成所考察的算法往往需要更多时间,很多算法的时间复杂度都超过 O(n)。在这种情况下,开发者有时必须做出折中,例如适当下降分析的准确性和优化的有效性,来阻止编译时间上升到不可接受的程度。