VectorCGRA的MultiCGRA实现——片上网络分析
在MeshMultiCgraRTL.py的Connections部分中,有两种互连方式
方式一
    for i in range(s.num_cgras):
        s.mesh.send[i] //= s.cgra[i].recv_from_inter_cgra_noc
        s.mesh.recv[i] //= s.cgra[i].send_to_inter_cgra_noc
方式二
    for cgra_row in range(cgra_rows):
      for cgra_col in range(cgra_columns):
        if cgra_row != 0:
          for tile_col in range(tile_columns):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_south[tile_col] //= \
                s.cgra[(cgra_row - 1) * cgra_columns + cgra_col].recv_data_on_boundary_north[tile_col]
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_south[tile_col] //= \
                s.cgra[(cgra_row - 1) * cgra_columns + cgra_col].send_data_on_boundary_north[tile_col]
        else:
          for tile_col in range(tile_columns):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_south[tile_col].rdy //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_south[tile_col].val //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_south[tile_col].msg //= CgraDataType()

        if cgra_row == cgra_rows - 1:
          for tile_col in range(tile_columns):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_north[tile_col].rdy //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_north[tile_col].val //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_north[tile_col].msg //= CgraDataType()

        if cgra_col != 0:
          for tile_row in range(tile_rows):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_west[tile_row] //= \
                s.cgra[cgra_row * cgra_columns + cgra_col - 1].recv_data_on_boundary_east[tile_row]
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_west[tile_row] //= \
                s.cgra[cgra_row * cgra_columns + cgra_col - 1].send_data_on_boundary_east[tile_row]
        else:
          for tile_row in range(tile_rows):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_west[tile_row].rdy //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_west[tile_row].val //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_west[tile_row].msg //= CgraDataType()

        if cgra_col == cgra_columns - 1:
          for tile_row in range(tile_rows):
            s.cgra[cgra_row * cgra_columns + cgra_col].send_data_on_boundary_east[tile_row].rdy //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_east[tile_row].val //= 0
            s.cgra[cgra_row * cgra_columns + cgra_col].recv_data_on_boundary_east[tile_row].msg //= CgraDataType()
分别表示CGRA和Mesh网络的互连和邻接的CGRA的边界互连,在前一种互连中,传输的是NocPktType,包头含有目的CGRA的坐标和目的Tile的ID信息,而后一种互连传输的CgraDataType是纯粹的数据。
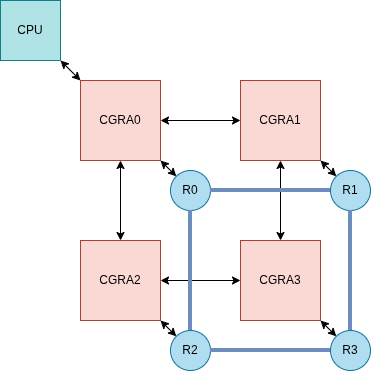
所有CGRA都需要来自cpu的控制消息工作,但仅有CGRA0实际上与CPU相连
    s.recv_from_cpu_pkt //= s.cgra[0].recv_from_cpu_pkt
    s.send_to_cpu_pkt //= s.cgra[0].send_to_cpu_pkt
在ControllerRTL.py中,我们可以看到,CGRA0实际上将来自CPU的信息通过MeshNetwork转发给了其他CGRA
      s.crossbar.recv[kFromCpuCtrlAndDataIdx].msg @= \
          ControllerXbarPktType(0, # dst (always 0 to align with the single outport of the crossbar, i.e., NoC)
                                InterCgraPktType(s.cgra_id, # src
                                                 s.recv_from_cpu_pkt_queue.send.msg.dst_cgra_id, # dst
                                                 0, # src_x
                                                 0, # src_y
                                                 s.idTo2d_x_lut[s.recv_from_cpu_pkt_queue.send.msg.dst_cgra_id], # dst_x
                                                 s.idTo2d_y_lut[s.recv_from_cpu_pkt_queue.send.msg.dst_cgra_id], # dst_y
                                                 num_tiles, # src_tile_id, num_tiles is used to indicate the request is from CPU, so the LOAD response can come back.
                                                 s.recv_from_cpu_pkt_queue.send.msg.dst, # dst_tile_id
                                                 0, # remote_src_port, only used for inter-cgra remote load request/response.
                                                 0, # opaque
                                                 0, # vc_id
                                                 s.recv_from_cpu_pkt_queue.send.msg.payload))
而在MeshNetworkRTL.py中可以看到,MeshNetwork由Routers、在Routers间网格状互连的Channels(可以被参数化地设置为有延迟的非理想通道)以及每个Routers和对应CGRA互连的接口组成,于是下面这张图大致描述了一个MeshMultiCGRA的架构
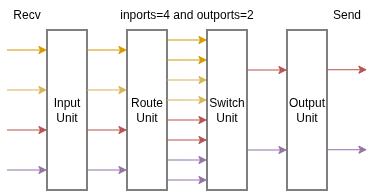
通过深入到路由的实现中,可以进一步理解MeshNetwork这个片上网络实现。一个网络中的路由InputUnit、RouteUnit、SwitchUnit和OutputUnit这4个单元组成,其中,分别执行路由逻辑和仲裁逻辑的RouteUnit和SwitchUnit最为重要。
在代码中,RouteUnit使用DORYMeshRouteUnitRTL实现了一个Y-X路由算法(先沿Y轴走到纵坐标与Y相同、再沿X走到目标)
    @update
    def up_ru_routing():
      s.out_dir @= Bits3(0)
      for i in range( num_outports ):
        s.send[i].val @= Bits1(0)

      if s.recv.val:
        if (s.pos.pos_x == s.recv.msg.dst_x) & (s.pos.pos_y == s.recv.msg.dst_y):
          s.out_dir @= SELF
        elif s.recv.msg.dst_y < s.pos.pos_y:
          s.out_dir @= SOUTH
        elif s.recv.msg.dst_y > s.pos.pos_y:
          s.out_dir @= NORTH
        elif s.recv.msg.dst_x < s.pos.pos_x:
          s.out_dir @= WEST
        else:
          s.out_dir @= EAST
        s.send[ s.out_dir ].val @= Bits1(1)
而SwitchUnit中实现了一个RoundRobinArbiterEn仲裁器,仲裁器的逻辑是从某个指针开始顺时针的第一个请求的获得许可,并将指针设置为这个请求的下家,下面的代码就是通过将授权者的one-hot表示循环左移一位来设置优先级指针的代码
    m.in_[1:nreqs] //= s.grants[0:nreqs-1]
    m.in_[0]       //= s.grants[nreqs-1]
一共有inports个InputUnit分别连接inports个RouteUnit,每个RouteUnit有outports个输出(RouteUnit是一个一对多分路器)
一共有outports个OutputUnit分别连接outports个SwitchUnit,每个SwitchUnit有inports个输入(SwitchUnit是一个多选一多路选择器)
SwitchUnit的inports个输入分别连接每个RouteUnit对应outport的输出端口
虽然RouteUnit在连接上是一个分路器,但实际传输的包只会被路由到一个方向,并不会被多播,这是因为RouteUnit通过将其他路的val信号置零,仅由Y-X路由算法决定的方向val信号置1使得包只沿正确的道路前进。
下面这张图展示了Router中inports=4 outports=2时的各单元的连接方式(仅供演示、实际上所有router中inports和outports都为5)